




Modelul de clustering cel mai strâns legat de statistică se bazează pe modele de distribuție. Clusterele bazate pe distribuție pot fi apoi definite cu ușurință ca obiecte aparținând cel mai probabil aceleiași distribuții. O proprietate convenabilă a acestei abordări este că aceasta seamănă foarte mult cu modul în care sunt generate seturile de date artificiale: prin eșantionarea obiectelor aleatorii dintr-o distribuție.
Deși fundamentul teoretic al acestor metode este excelent, ele suferă de o problemă cheie cunoscută sub denumirea de supraadaptare, cu excepția cazului în care sunt impuse constrângeri asupra complexității modelului. Un model mai complex va putea, de obicei, să explice mai bine datele, ceea ce face ca alegerea complexității modelului potrivit să fie dificilă în mod inerent.
O metodă proeminentă este cunoscută sub denumirea de modele de amestec gaussiene (folosind algoritmul de așteptare-maximizare). Aici, setul de date este de obicei modelat cu un număr fix (pentru a evita supraadaptarea) de distribuții gaussiene care sunt inițializate aleatoriu și ai căror parametri sunt optimizați iterativ pentru a se potrivi mai bine cu setul de date. Acest lucru va converge către un optim local, astfel încât mai multe rulări pot produce rezultate diferite. Pentru a obține un clustering hard, obiectele sunt adesea atribuite distribuției gaussiene căreia îi aparțin cel mai probabil; pentru clustering soft, acest lucru nu este necesar.
Gruparea bazată pe distribuție produce modele complexe pentru clustere care pot captura corelația și dependența dintre atribute. Cu toate acestea, acești algoritmi pun o povară suplimentară pentru utilizator: pentru multe seturi de date reale, este posibil să nu existe un model matematic definit concis (de exemplu, presupunerea distribuțiilor gaussiene este o presupunere destul de puternică asupra datelor).
Exemple de clustering așteptare-maximizare:
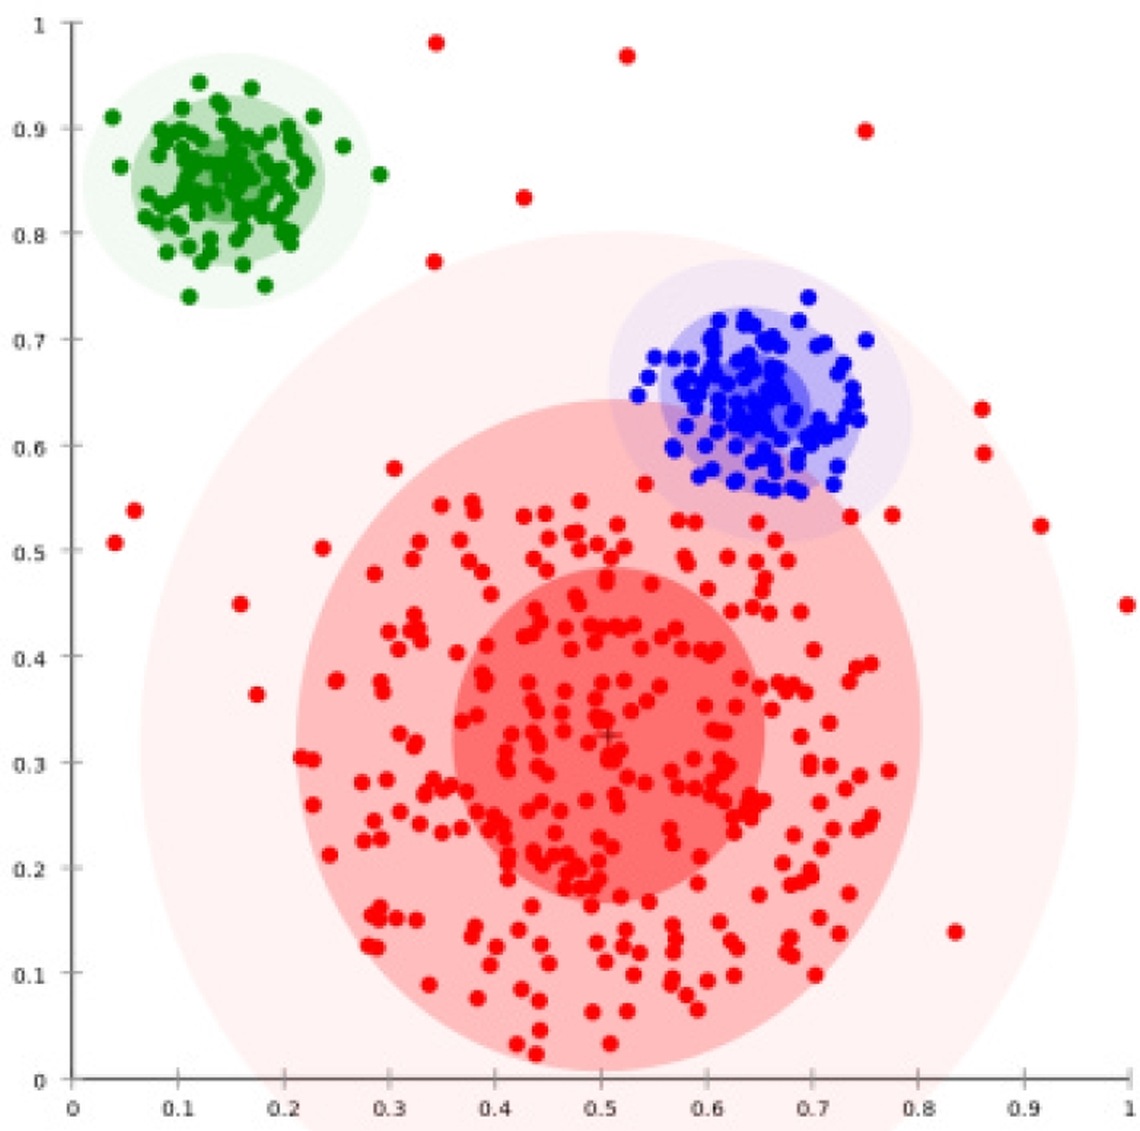 (Pe datele distribuite gaussian, clusteringul așteptare-maximizare funcționează bine, deoarece folosește gaussieni pentru modelarea clusterelor)
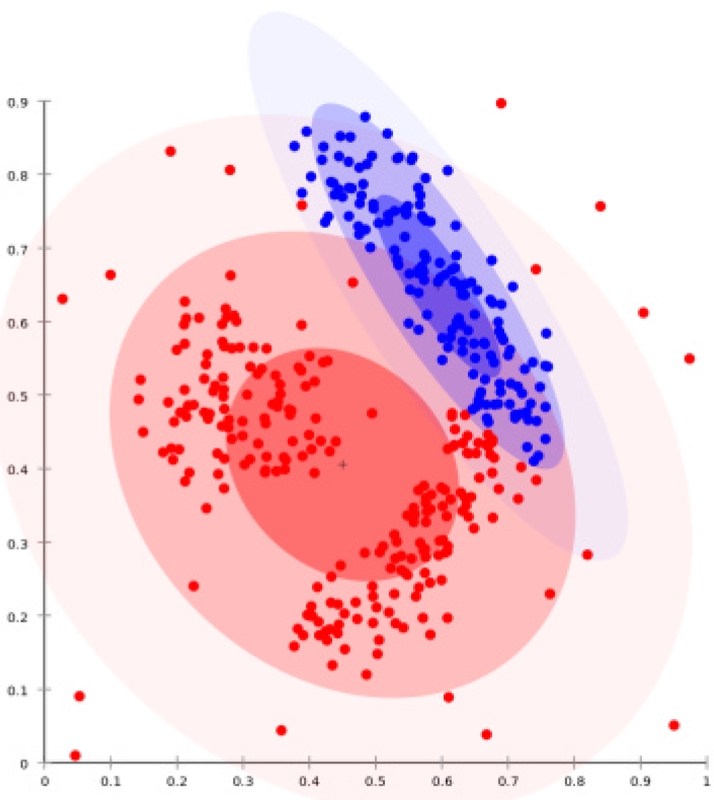 (Clusterele bazate pe densitate nu pot fi modelate folosind distribuții gaussiene)
Sursa: Drew Bentley, Business Intelligence and Analytics. © 2017 Library Press, Licență CC BY-SA 4.0. Traducere și adaptare: Nicolae Sfetcu

Analitica rețelelor sociale
Descoperă puterea datelor și transformă modul în care înțelegi și utilizezi rețelele sociale.

Introducere în inteligența artificială
Pășește în era digitală pregătit să înțelegi și să aplici conceptele care schimbă lumea!

Etica Big Data în cercetare
O explorare critică a provocărilor etice și a implicațiilor legale asociate Big Data.
Descoperă mai multe la MultiMedia
Abonează-te ca să primești ultimele articole prin email.




Lasă un răspuns