




Să presupunem că încercăm să facem recomandări pentru Amy căreia îi place Phoenix, Passion Pit și Vampire Weekend. Cel mai apropiat potrivire al nostru este Bob, căruia îi place, de asemenea, Phoenix, Passion Pit și Vampire Weekend. Tatăl lui se întâmplă să cânte la acordeon pentru Walter Ostanek Band, câștigătorul Grammy de anul acesta la categoria polca. Din cauza obligațiilor familiale, Bob acordă 5 stele trupei Walter Ostanek. Pe baza sistemului nostru actual de recomandare, credem că lui Amy îi va place cu adevărat trupa. Dar bunul simț ne spune că probabil că nu este așa.
Sau gândiți-vă la profesorul Billy Bob Olivera, căruia îi place să citească diverse cărți de minerit de date și știinșifico-fantastice. Cea mai apropiată potrivire a lui se întâmplă să fiu eu, fiindcă îmi plac și cărțile de minerit de date și cele știinșifico-fantastice. Dar îmi plac pudelii standard și am apreciat foarte mult The Secret Lives of Standard Pudels. Sistemul nostru actual de recomandare ar recomanda probabil acea carte profesorului.
Problema este că ne bazăm pe o singură persoană „cea mai asemănătoare”. Orice ciudație pe care o are persoana respectivă este transmisă ca recomandare. O modalitate de a compensa aceste ciudățenii este să ne bazăm recomandările de la mai multe persoane similare cu preferințele utilizatorului nostru. Pentru aceasta, putem folosi abordarea ”cei mai apropiați k vecini”.
Cei mai apropiați k vecini
În abordarea ”cei mai apropiați k vecini” pentru filtrarea colaborativă, folosim cele mai similare k persoane pentru a determina recomandări. Cea mai bună valoare pentru k este specifică aplicației – va trebui să faceți ceva experimente. Iată un exemplu pentru a vă oferi ideea de bază.
Să presupunem că aș dori să fac recomandări pentru Ann și că folosesc cei mai apropiați k vecini, cu k=3. Cei mai apropiați trei vecini și scorurile lor Pearson sunt prezentate în următorul tabel:
| Persoana | Scor Pearson |
| Sally | 0.8 |
| Eric | 0.7 |
| Amanda | 0.5 |
0.8 + 0.7 + 0.5 = 2.0
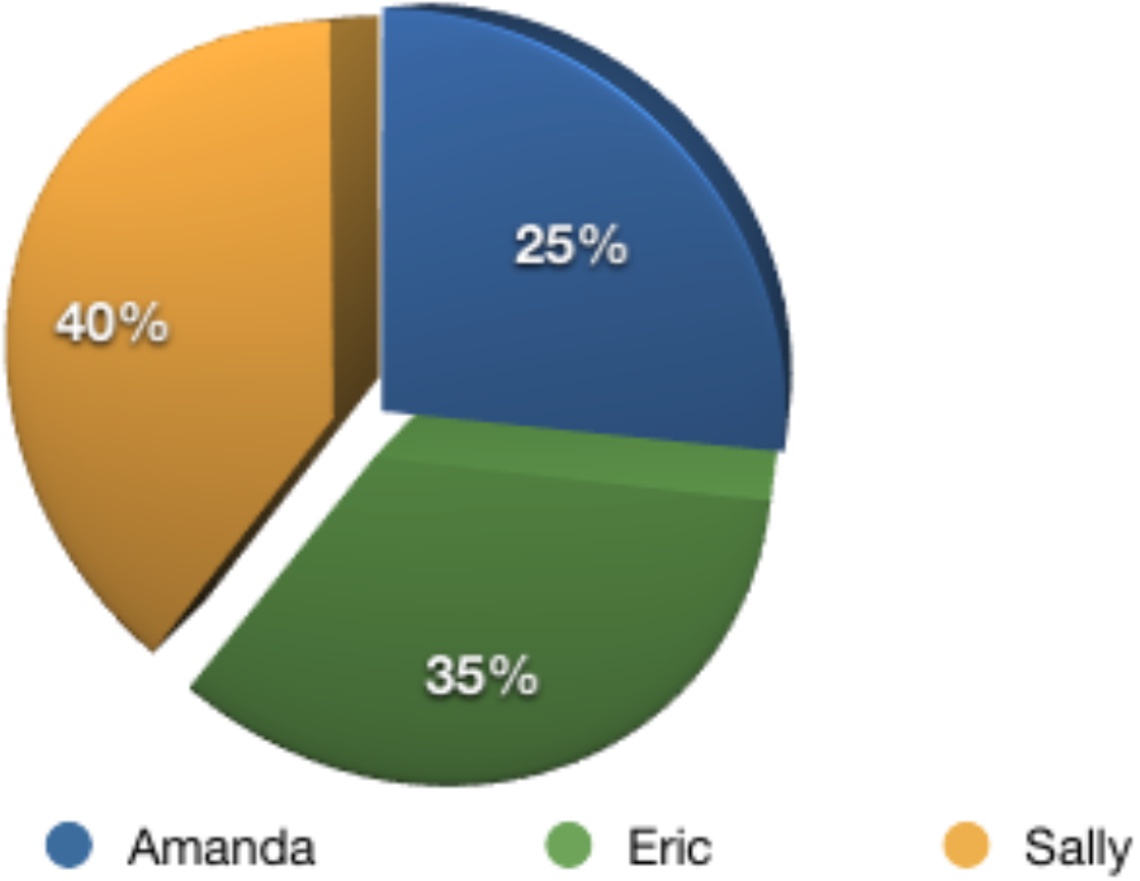
Fiecare dintre aceste trei persoane va influența recomandările. Întrebarea este cum pot determina cât de multă influență ar trebui să aibă fiecare persoană. Dacă desenăm o diagramă de influență, cât de mare ar trebui să fie alocarea pentru fiecare persoană? Dacă adun scorurile Pearson, obțin 2. Cota lui Sally este 0,8/2 sau 40%. Cota lui Eric este de 35% (0,7 / 2), iar cota lui Amanda este de 25%.
Să presupunem că Amanda, Eric și Sally au evaluat trupa The Grey Wardens după cum urmează
| Persoana | Rating pentru Grey Wardens |
| Amanda | 4.5 |
| Eric | 5 |
| Sally | 3.5 |
| Persoana | Rating pentru Grey Wardens | Influența |
| Amanda | 4.5 | 25.00% |
| Eric | 5 | 35.00% |
| Sally | 3.5 | 40.00% |
Evaluarea proiectată = (4,5 x 0,25) + (5 x 0,35) + (3,5 x 0,4) = 4,275
Exerciții
Să presupunem că folosesc aceleași date ca mai sus, dar folosesc o abordare a celor mai apropiați vecini cu k=2. Care este evaluarea mea proiectată pentru Grey Wardens?
| Persoana | Scor Pearson |
| Sally | 0.8 |
| Eric | 0.7 |
| Amanda | 0.5 |
| Persoana | Rating Grey Wardens |
| Amanda | 4.5 |
| Eric | 5 |
| Sally | 3.5 |
Rezolvare
Evaluare proiectată = partea lui Sally + partea lui Eric = (3,5 x (0,8 / 1,5)) + (5 x (0,7 / 1,5)) = (3,5 x 0,5333) + (5 x 0,4667) = 1,867 + 2,333 = 4,2
Sursa: Ron Zacharski, A Programmer’s Guide to Data Mining – The Ancient Art of the Numerati. Licența CC BY-NC 3.0. Traducere și adaptare: Nicolae Sfetcu
Articol oferit sub licență CC BY-NC 3.0
Descoperă mai multe la MultiMedia
Abonează-te ca să primești ultimele articole prin email.




Lasă un răspuns