




În activitatea de clasificare, variabila țintă pe care dorim să o prezicem este categorială. Uneori numim această variabilă și etichetă. Deoarece acesta este un proces supravegheat, ni se oferă exemple de obiecte de studiu care au „răspunsuri adevărate” cunoscute. Acestea se numesc exemple etichetate. Scopul activității este de a produce predicții bune ale etichetelor pentru alte exemple neetichetate. Un program care poate face astfel de predicții, după ce a studiat exemplele etichetate, se numește clasificator.
Eticheta prezisă poate fi văzută ca „ieșirea” din clasificatorul nostru. Toate celelalte variabile sunt, în esență, intrările în procesul nostru, pe care le folosim pentru a face predicțiile noastre. Aceste variabile se numesc caracteristici (sau uneori, atribute).
În ceea ce privește structurile de date Pandas, toate aceste exemple etichetate vor fi în mod normal ambalate într-un DataFrame. Fiecare rând al DataFrame-ului va fi un exemplu etichetat, cu caracteristicile sale ca niște coloane și ținta/eticheta sa ca o coloană (în mod tradițional, cea din dreapta).
Acest lucru este ilustrat în Figura 26.1. Iată câteva exemple etichetate pentru un set de date despre fanii NFL. Fiecare rând reprezintă un fan și prezintă diverse caracteristici ale existenței sale – vârsta sa, locul în care s-a născut, unde locuiește acum și câți ani a trăit în reședința sa actuală. Coloana din dreapta indică ținta: echipa căreia acest fan i-a jurat credință. Scopul nostru ar fi să prezicem cu ce echipă ar putea ține un fan, pe baza a ceea ce știm despre el. Ca să nu credeți că acest exemplu este frivol, gândiți-vă că o companie de articole sportive ar putea dori să trimită cataloage (pe hârtie sau electronice) potențialilor clienți și probabil ar crește vânzările dacă imaginea de copertă a catalogului ar prezenta un model purtând îmbrăcăminte din echipa favorită a clientului, mai degrabă decât din rivala sa.
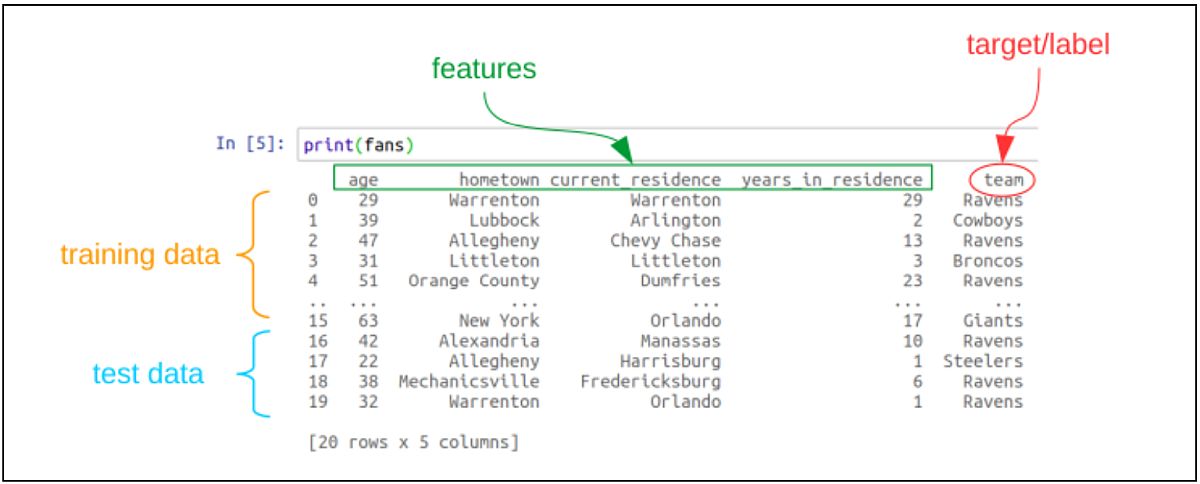
Figura 26.1: Câteva exemple etichetate, împărțite în seturi de antrenament și de testare.
Veți vedea, de asemenea, în figură că am împărțit rândurile în două grupuri. Primul grup se numește datele de antrenament, iar al doilea, datele de testare. (În mod normal, vom amesteca toate rândurile înainte de a le atribui, astfel încât să nu punem toate rândurile de sus ale DataFrame-ului în setul de antrenament și toate cele de jos în setul de test. Dar acest lucru este mai greu de arătat într-o imagine.)
Sursa: Stephen Davies, The Crystal Ball – Instruction Manual, Vol. 1: Introduction to Data Science, v. 1.1. Copyright © 2021 Stephen Davies. Licența CC BY-SA 4.0. Traducere și adaptare: Nicolae Sfetcu. © 2024 MultiMedia Publishing, Introducere în Știința Datelor, Volumul 1

Speranța nemuririi – Reflecții despre moarte și supraviețuire
Despre moarte s-a scris şi se va mai scrie, fără îndoială, moartea fiind inevitabilă, sfârşitul vieţii oricui, după cum consideră unii filozofi… Problema este însă dacă moartea este sfârşitul absolut al vieţii unui om sau dacă, după moarte, mai urmează … Citeşte mai mult

Tehnologia informației și comunicațiilor în România: Analiza comparativă cu UE, impactul social, provocări și oportunități, direcții viitoare
Ideal Pentru: Decidenți politici, cercetători și pasionați de TIC pregătiți să exploreze potențialul României în sfera digitală europeană.

Mecanica cuantică fenomenologică
Intră în lumea fascinantă a mecanicii cuantice. Nu rata ocazia de a explora frontierele științei!
Descoperă mai multe la MultiMedia
Abonează-te ca să primești ultimele articole prin email.




Lasă un răspuns