




Când un jucător de golf învață pentru prima dată să joace golf, își petrece de obicei cea mai mare parte a timpului dezvoltând un swing de bază. Abia treptat dezvoltă alte lovituri, învățând să execute chipuri, draw și fade cu mingea, dezvoltând și modificându-și swing-ul de bază. În mod similar, până acum ne-am concentrat pe înțelegerea algoritmului de retropropagare. Este „swing-ul nostru de bază”, fundamentul învățării în majoritatea lucrărilor despre rețelele neuronale. În acest capitol, explic o suită de tehnici care pot fi utilizate pentru a îmbunătăți implementarea noastră standard a retropropagarii și, astfel, pentru a îmbunătăți modul în care rețelele noastre învață.
Tehnicile pe care le vom dezvolta în acest capitol includ: o alegere mai bună a funcției de cost, cunoscută sub numele de funcția de cost a entropiei încrucișate; patru așa-numite metode de „regularizare” (regularizarea L1 și L2, abandonul și extinderea artificială a datelor de antrenament), care fac rețelele noastre mai bune la generalizarea dincolo de datele de antrenament; o metodă mai bună pentru inițializarea ponderilor din rețea; și un set de euristici care să ajute la alegerea unor hiperparametri buni pentru rețea. De asemenea, voi prezenta în detaliu și alte câteva tehnici. Discuțiile sunt în mare măsură independente una de cealaltă, așa că puteți trece mai departe dacă doriți. De asemenea, vom implementa multe dintre tehnici în codul de rulare și le vom folosi pentru a îmbunătăți rezultatele obținute la problema clasificării scrisului de mână studiată în Capitolul 1.
Desigur, acoperim doar câteva dintre numeroasele tehnici care au fost dezvoltate pentru utilizare în rețele neuronale. Filosofia este că cea mai bună intrare în multitudinea de tehnici disponibile este studiul aprofundat al câtorva dintre cele mai importante. Stăpânirea acestor tehnici importante nu este doar utilă în sine, ci va aprofunda și înțelegerea problemelor care pot apărea atunci când utilizați rețele neuronale. Acest lucru vă va pregăti să învățați rapid alte tehnici, pe măsură ce aveți nevoie de ele.
Funcția de cost al entropiei încrucișate
Cei mai mulți dintre noi considerăm neplăcut să greșim. La scurt timp după ce am început să învăț la pian, am susținut prima mea reprezentație în fața unui public. Eram nervos și am început să cânt piesa cu o octavă prea jos. M-am încurcat și nu am putut continua până când cineva nu mi-a arătat greșeala. M-am simțit foarte jenat. Totuși, deși neplăcut, învățăm și repede când greșim în mod decisiv. Puteți paria că data viitoare când am cântat în fața unui public am cântat în octava corectă! Prin contrast, învățăm mai lent atunci când erorile noastre sunt mai puțin bine definite.
În mod ideal, sperăm și ne așteptăm ca rețelele noastre neuronale să învețe rapid din erorile lor. Se întâmplă asta în practică? Pentru a răspunde la această întrebare, să ne uităm la un exemplu de jucărie. Exemplul implică un neuron cu o singură intrare:
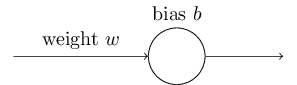
Vom antrena acest neuron să facă ceva ridicol de ușor: să ducă intrarea 1 la ieșirea 0. Desigur, aceasta este o sarcină atât de banală încât am putea cu ușurință să calculăm manual o pondere și o tendință adecvate, fără a utiliza un algoritm de învățare. Cu toate acestea, se dovedește a fi revelator să folosim coborârea în gradient pentru a încerca să învățăm o pondere și o tendință. Așadar, să aruncăm o privire la modul în care învață neuronul.
Pentru a clarifica lucrurile, voi alege ponderea inițială la 0,6 și abaterea inițială la 0,9. Acestea sunt opțiuni generice folosite ca punct de plecare pentru învățare, nu le-am ales ca să fie speciale în vreun fel. Rezultatul inițial al neuronului este 0,820,82, așa că va fi nevoie de multă învățare înainte ca neuronul nostru să se apropie de rezultatul dorit, 0,0. Faceți clic pe „Run” (Executare) în colțul din dreapta jos pentru a vedea cum neuronul învață un rezultat mult mai apropiat de 0,0. Rețineți că aceasta nu este o animație preînregistrată, browserul dvs. calculează de fapt gradientul, apoi folosește gradientul pentru a actualiza ponderea și abaterea și afișează rezultatul. Rata de învățare este η = 0,15, care se dovedește a fi suficient de lentă pentru a putea urmări ce se întâmplă, dar suficient de rapidă pentru a putea obține o învățare substanțială în doar câteva secunde. Costul este funcția de cost pătratică, C, introdusă în Capitolul 1. Vă voi reaminti în scurt timp forma exactă a funcției de cost, deci nu este nevoie să căutați definiția. Rețineți că puteți rula animația de mai multe ori făcând clic din nou pe „Run”.
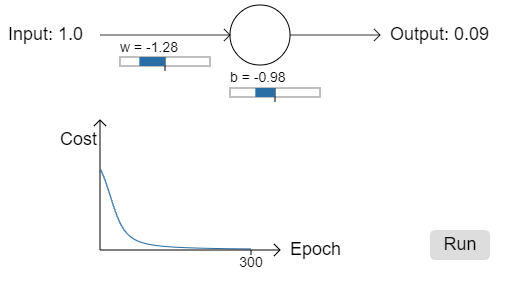
După cum puteți vedea, neuronul învață rapid o pondere și o tendință care reduc costul și oferă un rezultat de la neuron de aproximativ 0,09. Acesta nu este chiar rezultatul dorit, 0,0, dar este destul de bun. Să presupunem, totuși, că alegem în schimb atât ponderea inițială, cât și tendința inițială să fie 2,0. În acest caz, rezultatul inițial este 0,98, ceea ce este foarte greșit. Să vedem cum învață neuronul să genereze 0 în acest caz. Faceți clic din nou pe „Run”:
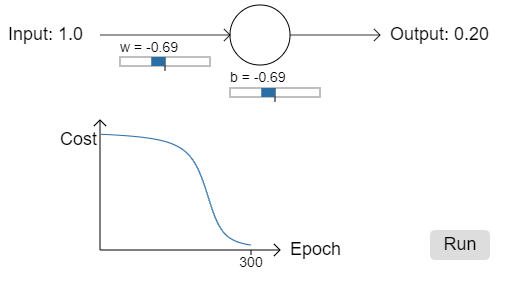
Deși acest exemplu folosește aceeași rată de învățare (η = 0,15), putem observa că învățarea începe mult mai lent. Într-adevăr, pentru primele 150 de perioade de învățare, ponderile și erorile nu se schimbă prea mult. Apoi, învățarea intră în acțiune și, la fel ca în primul nostru exemplu, ieșirea neuronului se apropie rapid de 0,0.
Acest comportament este ciudat în comparație cu învățarea umană. După cum am spus la începutul acestei secțiuni, adesea învățăm cel mai rapid atunci când greșim amarnic în legătură cu ceva. Dar tocmai am văzut că neuronul nostru artificial are mari dificultăți în a învăța atunci când greșește amarnic – cu mult mai multă dificultate decât atunci când greșește puțin. Mai mult, se pare că acest comportament apare nu doar în acest model de jucărie, ci și în rețele mai generale. De ce este învățarea atât de lentă? Și putem găsi o modalitate de a evita această încetinire?
Pentru a înțelege originea problemei, luați în considerare faptul că neuronul nostru învață prin schimbarea ponderării și a erorii la o rată determinată de derivatele parțiale ale funcției de cost, ∂C/∂w și ∂C/∂b. Deci, a spune că „învățarea este lentă” este de fapt același lucru cu a spune că acele derivate parțiale sunt mici. Provocarea este să înțelegem de ce sunt mici. Pentru a înțelege acest lucru, haideți să calculăm derivatele parțiale. Reamintim că folosim funcția de cost pătratică, care, din ecuația (6), este dată de
C = (y − a)2/2, (54)
unde a este ieșirea neuronului atunci când se utilizează intrarea de antrenament x = 1, iar y = 0 este ieșirea dorită corespunzătoare. Pentru a scrie acest lucru mai explicit în termeni de pondere și bias, reamintim că a = σ(z), unde z = wx + b. Folosind regula lanțului pentru a diferenția în funcție de pondere și bias, obținem
∂C/∂w = (a − y)σ'(z)x = aσ'(z) (55)
∂C/∂w = (a − y)σ'(z) = aσ'(z) (56)
unde am substituit x=1 și y=0. Pentru a înțelege comportamentul acestor expresii, să analizăm mai atent termenul σ'(z) din partea dreaptă. Reamintim forma funcției σ:
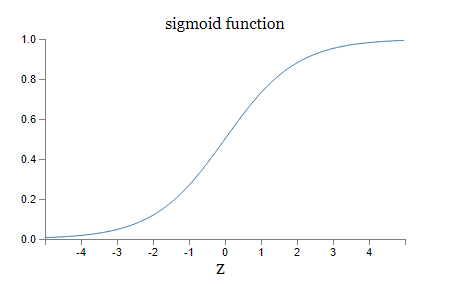
Putem observa din acest grafic că atunci când ieșirea neuronului este aproape de 1, curba devine foarte plată, așadar σ'(z) devine foarte mică. Ecuațiile 55 și 56 ne spun apoi că ∂C/∂w și ∂C/∂b devin foarte mici. Aceasta este originea încetinirii învățării. Mai mult, așa cum vom vedea puțin mai târziu, încetinirea învățării apare în esență din același motiv în rețelele neuronale mai generale, nu doar în exemplul de jucărie cu care ne-am jucat.
Sursa: Michael Nielson (2024). Neural Networks and Deep Learning, LibreTexts, licența CC BY-NC 3.0. Traducerea și adaptarea Nicolae Sfetcu

Emigrantul
Trenul alerga în noapte, deznădejdea şi amărăciunea erau lăsate în urmă, purta cu el în suflet curajul, multe speranţe. Va munci, va face orice, în ţară nu va mai veni decât bogat, cu visul împlinit, sau mort între patru scânduri. … Citeşte mai mult

Inducție electromagnetică „de masă”
Sfetcu, Nicolae (2025). ”Inducție electromagnetică „de masă””, în Index Academic, I 2025, DOI: 10.58679/IA67348 PDF: https://www.indexacademic.ro/pdf/inductie-electromagnetica-de-masa/ HTML: https://www.telework.ro/ro/inductie-electromagnetica-de-masa/ Concepte: legea lui Faraday, flux variabil. Ce faci: bobină ~500–1000 spire (fir subțire) + magnet neodim; muți magnetul în/afară. Măsori: … Citeşte mai mult

Despre jocul de bridge
Bridge este un joc de levate cu cărți de joc folosind un pachet standard de 52 de cărți. Este jucat de patru jucători în două grupați în două echipe concurente, partenerii stând față în față la masa de joc. Milioane … Citeşte mai mult
Descoperă mai multe la MultiMedia
Abonează-te ca să primești ultimele articole prin email.


Lasă un răspuns