




Bine ați venit în cea mai rea dintre toate lumile posibile[1]: atunci când datele pe care doriți să le analizați se află undeva pe un site web ușor de citit de om, dar neprietenos cu mașinile. Sunt acolo, le puteți vedea… dar a le transfera de pe o pagină web frumoasă într-un Pandas DataFrame este o situație non-trivială.
De obicei, această situație apare atunci când furnizorul datelor și designerul site-ului web nu au prevăzut că cineva va folosi datele în alt scop decât vizualizarea lor prin intermediul site-ului web în sine. Uneori există un alt motiv: organizația a dorit să facă în mod deliberat această operațiune dificilă, astfel încât să nu le puteți utiliza cu ușurință în alte scopuri. În orice caz, însă, atâta timp cât datele sunt accesibile și vizibile prin browserul dvs., acestea sunt, cel puțin teoretic, extractibile în forma de care avem nevoie pentru a ne face magia.
HTML
(Cele mai multe) pagini web arată elegant și colorat atunci când le vizualizezi: cuvântul „cod” nu îți vine imediat în minte. Totuși, când încarci o pagină web, ceea ce primești de fapt de la serverul specificat este un fișier text simplu scris într-un limbaj numit HTML sau limbaj de marcare hipertext. Acesta constă dintr-o combinație de comenzi de conținut și formatare/structură (sau „marcare”) pentru a instrui browserul cum să redea pagina. („A reda” o pagină înseamnă „a interpreta toate acele chestii de formatare HTML și a prezenta de fapt o pagină frumoasă formatată așa cum specifică).
Primul lucru de care trebuie să-l știți este că HTML nu este un limbaj de programare. (Adică, nu puteți scrie un program în el.) Este strict o sintaxă de formatare pentru a specifica modul în care ar trebui să fie așezate elementele text și grafice. Dacă întrebați vreodată pe cineva dacă a făcut programare pe calculator și vă spune: „da, am făcut programare în HTML”, să știți că minte.
Al doilea lucru de știut este că este ierarhic, nu plat. Acest lucru îl face mai asemănător cu JSON decât cu CSV. Chiar dacă fiecare fișier HTML este o singură secvență de caractere, acesta codifică o structură asemănătoare arborelui în care elementele pot exista în interiorul altor elemente, care pot exista în interiorul altor elemente etc., fără limită a numărului de imbricare.
Partea constitutivă de bază al HTML este elementul, care este delimitat de etichete de început și de sfârșit. Etichetele sunt cuvinte cheie, majoritatea indicând ceva structural sau stilistic, închise între paranteze unghiulare („< … >”). Eticheta de sfârșit are o bară oblică. („/”) imediat înaintea cuvântului cheie, indicând faptul că acesta se potrivește cu eticheta de deschidere corespunzătoare. Așadar, o pereche de etichete de început și de sfârșit ar putea fi „<title>” și „</title>”.
Rețineți că întregul conținut al elementului este (1) eticheta de început, (2) eticheta de sfârșit și (3) tot ce se află între ele, care ar putea fi text pe lângă alte elemente.
Un exemplu de fișier HTML
Figura 15.1 prezintă un exemplu foarte simplu, dar complet. Se întâmplă multe lucruri acolo. Prima modalitate de a vă orienta este să începeți să aliniați vizual etichetele de început cu etichetele de sfârșit corespunzătoare și să percepeți structura. Observați că întreaga pagină începe cu „<html>” și se termină cu „</html>”. Acesta este, în esență, „nodul rădăcină” al întregului arbore ierarhic al paginii[2]. Are doi „copii” imediati: un element head și un element body. Fiecare dintre aceștia are și etichete de început și de sfârșit. În interiorul elementului head se află un element title etc.
După cum puteți ghici, fiecare dintre aceste etichete este interpretată de browser ca însemnând un anumit tip de structură/formatare. „h1” înseamnă „titlu de nivel superior”, ceea ce, în practică, înseamnă „a-l afișa cu un font mare, cu puțin spațiu suplimentar în jurul lui”. Elementul „b” înseamnă a pune ceva cu caractere aldine. Elementul „table” înseamnă a construi o structură asemănătoare unui tabel, cu rânduri („tr”) și celule în interiorul rândurilor („td”). Etc. HTML este, în general, o mare încurcătură de lucruri care ar trebui să indice structura (cum ar fi table și h2) și lucruri care specifică o formatare specifică (cum ar fi i și u). Toate acestea pot fi ușor de căutat online.
Unele etichete de început (nu cele de sfârșit) conțin informații suplimentare numite atribute. Puteți vedea acest lucru cu etichetele a și img din exemplu:
<a href="http://www.telework.ro/ro/stiri-6-august/">Știri, 6 august</a>
Eticheta a înseamnă „ancoră” și este cea mai comună modalitate de a încorpora un hyperlink (pe care puteți face clic pentru a merge la o altă pagină) într-un document. Rețineți că cuvintele care vor apărea în pagină sunt conținutul elementului, nu fac parte din eticheta în sine. Eticheta, pe lângă „a”-ul obligatoriu, are o pereche cheie/valoare unde cheia este șirul href, iar valoarea este adresa URL la care va fi direcționat utilizatorul dacă dă clic pe link. Această pereche cheie/valoare se numește atribut.
<img src=" https://www.telework.ro/wp-content/uploads/2025/06/newspapers-444447.jpg" width=1200 />
În exemplul img, avem două atribute: unul pentru numele fișierului imaginii și celălalt pentru câteva sugestii specifice de formatare (în acest caz, o lățime de 1200 de pixeli). Un element poate avea multe atribute diferite, în orice ordine.
(Apropo, cititorul atent ar fi putut observa și altceva ciudat la exemplul img de mai sus: o bară oblică suplimentară înainte de închiderea „>”. Aceasta este o prescurtare HTML pentru „începutul și sfârșitul elementului, totul într-o singură etichetă, deoarece oricum nu are conținut”. Ori de câte ori aveți ceva de forma „<x></x>”, îl puteți înlocui cu echivalentul „<x/>” pentru a economisi tastare și dimensiunea fișierului.)
<html>
<head>
<title>All About Stephen</title>
<style>
img { width:150px; }
td { border-width:1px; }
</style>
</head>
<body>
<h1>Stephen Davies, Esquire</h1>
<p>Deep in the bowels of
<a href="http://buildings.umwblogs.org/james-farmer-hall/">James Farmer
Hall</a> resides a carbon-based life form known to outsiders only as
<b>Stephen</b>. This mysterious being fulfills several roles <u>not</u>
widely known to humankind.</p>
<p><i>Some</i> of these functions are delineated below. Please memorize
them and then immediately destroy this page upon reading it.</p>
<h2>Areas of operation</h2>
<table border=2 cellpadding=15>
<tr><td class="pic"><img src="http://clipart.com/prof.jpg" width=200 />
</td>
<td class="role">College professor</td>
<td class="description">Stephen teaches computer science and data
science to willing undergraduates, shaping them into the heroes of
tomorrow.</td>
<td><ul><li>Super rewarding</li>
<li>Exciting</li>
<li>Ever-changing</li>
<li>Fun</li></ul></td>
<td><b>50%</b> of total time</td>
</tr>
<tr><td class="pic"><img src="http://clipart.com/dad.png" width=200 />
</td>
<td class="role">Dad</td>
<td class="description"> With a wife, three teenagers, and two cats
(one of whom throws up a lot), Stephen's home life is a constant
source of love, anxiety, and Hallmark moments.</td>
<td><ul><li>Amazing</li>
<li>Loving</li>
<li>Complicated</li>
<li>Surprising</li></ul></td>
<td><b>30%</b> of total time</td>
</tr>
...
</table>
</body>
</html>
Figura 15.1: Un exemplu de pagină HTML.
În cele din urmă, voi sublinia că aproape de începutul acestui exemplu, există o grămadă de lucruri care arată puțin cam urât din punct de vedere vizual; nu arată a HTML. Și nu este. Mă refer la acesta:
<style>
img { width:150px; }
td { border-width:1px; }
</style>
Acest cod se numește CSS (sau Cascading Style Sheets), care este un fel de tehnologie însoțitoare HTML-ului pentru a oferi un control suplimentar asupra formatării. (Inițial, HTML trebuia să delimiteze strict structura documentului, iar CSS putea fi apoi folosit pentru a specifica formatarea acelei structuri. Această separare strictă a aspectelor, care era o idee bună, a devenit însă foarte confuză în anii care au trecut.)
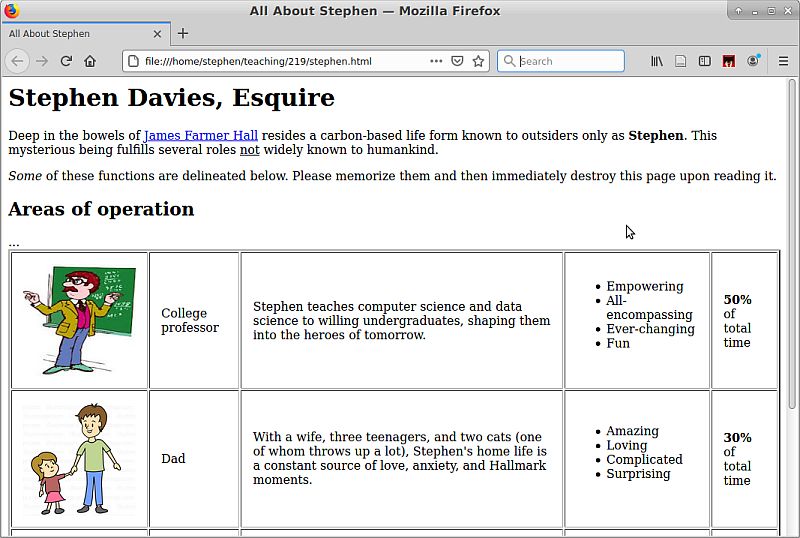
Întregul, odată redat, arată cam așa:
Note
[1] De fapt, a doua cea mai proastă problemă; cea mai proastă este atunci când datele pe care le căutați nici măcar nu sunt în format electronic.
[2] Folosesc termenul „arbore” aici în mare parte la fel ca arborii decizionali din volumul I al acestei serii. Rețineți că aceștia încep în vârf, cu o rădăcină, și se ramifică din ce în ce mai mult pe măsură ce sunt desenați în josul paginii.
Sursa: Stephen Davies, The Crystal Ball – Instruction Manual, Vol. 2: Introduction to Data Science, v. 1.1. Copyright © 2020 Stephen Davies. Licența CC BY-SA 4.0. Traducere și adaptare: Nicolae Sfetcu. © 2025 MultiMedia Publishing, Introducere în Știința Datelor, Volumul 2

Înțeles, sens și referință în filosofia limbajului și logica filosofică
Descoperă complexitatea gândirii și explorarea limbajului într-o manieră profundă și captivantă.

Corupţie – Globalizare – Neocolonialism
O carte esențială pentru toți cei interesați de realitățile sociale, economice și politice ale lumii moderne.

Fizica simplificată
Transformă-ți curiozitatea în cunoaștere! Explorează tainele universului!
Descoperă mai multe la MultiMedia
Abonează-te ca să primești ultimele articole prin email.


Lasă un răspuns