




În această secțiune, ne concentrăm asupra unor algoritmi populari de învățare automată din diferitele paradigme [1, 2, 3, 5] explicate în secțiunea precedentă. Deși numărul de algoritmi care se încadrează în fiecare paradigmă sunt numeroși și raportați în literatura de specialitate, în acest studiu luăm în considerare doar câțiva dintre aceștia. Următorul tabel 2 explică pe scurt câțiva dintre acești algoritmi.
Acești algoritmi au un domeniu larg de aplicații practice, dintre care unele sunt descrise în secțiunea următoare.
Tabelul 2. Algoritmi de învățare automată
| Paradigma | Algoritm | Descriere |
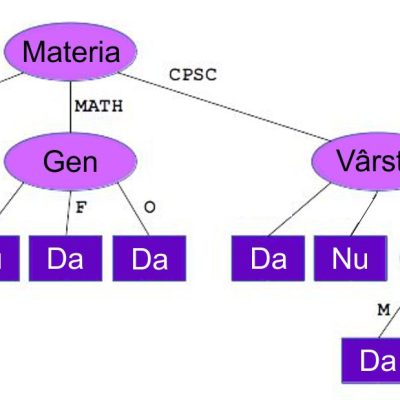
| Învățare supravegheată | Arbore de decizie | Arborele de decizie este o tehnică de aproximare a funcției țintă cu valori discrete care reprezintă funcția învățată sub forma unui arbore de decizie [4]. Un arbore de decizie clasifică instanțele sortându-le de la rădăcină la unele noduri frunze pe baza valorilor caracteristicilor. Fiecare nod reprezintă o decizie (condiție de testare) cu privire la atributul instanței, în timp ce fiecare ramură reprezintă o valoare posibilă pentru acea caracteristică. Clasificarea unei instanțe începe la nodul rădăcină numit nodul de decizie. Pe baza valorii nodului, arborele parcurge în jos de-a lungul marginii care corespunde valorii de ieșire a testului de caracteristică. Acest proces continuă în sub-arborele condus de noul nod de la sfârșitul marginii anterioare. În cele din urmă, nodul frunză semnifică categoriile de clasificare sau decizia finală. Când folosiți un arbore de decizie, concentrați-vă asupra modului de a decide care atribut este cel mai bun clasificator la fiecare nivel de nod. Măsura statistică, cum ar fi câștigul de informații, indicele Gini, Chi-pătratul și entropia sunt calculate pentru fiecare nod pentru a calcula valoarea acelui nod [4]. Mai mulți algoritmi sunt utilizați pentru implementarea arborilor de decizie. Cei mai populari sunt: Arborele de clasificare și regresie (CART), Iterative Dichotomizer 3 (ID3), Detecția automată a interacțiunii (CHAID), Chi-Squared C4.5 și C5.0 și M5 |
| Bayezian naiv | Bayezianul naiv clasifică folosind teorema probabilității lui Bayes. Teorema lui Bayes calculează probabilitatea posterioară a unui eveniment (A) având în vedere o probabilitate anterioară a evenimentului B reprezentată de P(A/B), după cum urmează:
P(B/A) = P(B/A)P(A)/P(B) Unde, • A și B sunt evenimente. Clasificatorii bayezieni naivi se încadrează în categoria clasificatorilor probabilistici simpli bazați pe conceptul teoremei lui Bayes având ipoteze de independență puternice printre caracteristici. |
| Este deosebit de potrivită atunci când dimensionalitatea intrărilor este mare [1,2]. | ||
| Mașini vectoriale de suport | SVM-urile pot fi utilizate pentru clasificare, precum și pentru probleme de regresie. Este un algoritm de învățare supravegheată. Funcționează pe conceptul de calculul marjei. În acest algoritm, fiecare element de date este reprezentat ca punct în spațiul n-dimensional (unde n este numărul de caracteristici pe care le avem în setul nostru de date). Valoarea fiecărei caracteristici este valoarea coordonatei corespunzătoare. Clasifică datele în diferite clase prin găsirea unei linii (hiperplan) care separă seturile de date de antrenament în clase. Funcționează prin maximizarea distanțelor dintre cel mai apropiat punct de date (în ambele clase) și hiperplanul pe care îl putem numi ca marjă. | |
| Analiza de regresie | Analiza regresiei este o tehnică de modelare predictivă care investighează relația dintre o variabilă dependentă (țintă) și o variabilă independentă (predictor). Este un instrument important pentru analiza și modelarea datelor. În această metodă, încercăm să potrivim linia/curba la punctele de date, astfel încât să minimizăm diferențele între distanțele punctelor de date față de curbă sau linie. Există diferite tipuri de analize de regresie, cum ar fi liniară, logistică și polinomială. | |
| Învățare nesupravegheată | Clustering de medii K (K-means) | K-means este un algoritm popular de învățare automată nesupravegheată pentru analiza clusterului. Scopul său este de a împărți „n” observații în „k” clustere în care fiecare observație aparține clusterului care are cea mai apropiată medie, servind ca prototip al clusterului. Media observațiilor dintr-un anumit cluster definește centrul clusterului. |
| Învățare bazată pe instanțe | Vecinii cei mai apropiați K (K-nearest), KNN | Este o metodă neparametrică utilizată pentru clasificare și regresie. Având în vedere N vectori de antrenament, algoritmul KNN identifică cei mai apropiați k vecini ai unui vector caracteristic necunoscut a cărui clasă urmează să fie identificată. |
| Învățare prin ansamblu | Pădure aleatorie de arbori decizionali | Este o metodă de învățare prin ansamblu utilizată în clasificare și regresie. Folosește abordarea cu ambalare pentru a crea o grămadă de arbori de decizie cu subset aleatoriu de date. Rezultatele tuturor arborilor de decizie din pădurea aleatorie sunt combinate pentru a crea arborii de decizie finală.Există două etape în algoritmul de pădure aleatorie, una este crearea unei păduri aleatorii, iar cealaltă este de a face o predicție din clasificatorul de pădure aleatorie creat în prima etapă. |
| Reducerea dimensionalității | Algoritmul componentei principale | Este folosit în principal pentru reducerea dimensionalității setului de date. Ajută la reducerea numărului de caracteristici ale setului de date sau a numărului de variabile independente din setul de date. Utilizează transformarea ortogonală pentru a converti variabile corelate într-un set de variabile necorelate liniar numite componente principale. |
Referințe
- [1] Sandhya N. dhage, Charanjeet Kaur Raina, “A review on Machine Learning Techniques”, March 16 Volume 4 Issue 3 , International Journal on Recent and Innovation Trends in Computing and Communication (IJRITCC), ISSN: 2321-8169, PP: 395 – 399
- [2] AyonDey , “Machine Learning Algorithms: A Review”, (IJCSIT) International Journal of Computer Science
- [3] A report by Royal Society, April 2017, “Machine learning: the power and promise of computers that learn by example “, ISBN: 978-1-78252-259-1.and Information Technologies, Vol. 7 (3) , 2016, 11741179
- [4] Shokri R, Stronati M, Song C, Shmatikov V. Membership inference attacks against machine learning models. InSecurity and Privacy (SP), 2017 IEEE Symposium on 2017 May 22 (pp. 3-18). IEEE.
- [5] Tom M. Mitchell , “Machine Learning “, WCB McGraw-Hill, 2013, ISBN-13:978-1-25-9096952, ISBN-10: 1-25-909695-5.
Sursa: Jafar Alzubi et al 2018 J. Phys.: Conf. Ser. 1142 012012, licența CC BY 3.0. Traducere: Nicolae Sfetcu

Analitica rețelelor sociale
Descoperă puterea datelor și transformă modul în care înțelegi și utilizezi rețelele sociale.
Tehnologia Blockchain – Bitcoin
Transformă-ți perspectiva asupra tehnologiei blockchain și începe să descoperi oportunitățile digitale de mâine!

Inteligența competitivă – Concept – Studii
Inteligența competitivă: instrumentul esențial pentru succesul în afaceri
Descoperă mai multe la MultiMedia
Abonează-te ca să primești ultimele articole prin email.




Lasă un răspuns