




Probabilitatea inversă permite deducerea necunoscutelor și realizarea de predicții. ML se bazează în principal pe trei piloni ai matematicii: algebra liniară, optimizarea și teoria probabilității, deși sunt implicate multe alte domenii matematice, vezi, de exemplu, [26]. Teoria probabilității [27] oferă limbajul matematic pentru reprezentarea și tratarea incertitudinii, la fel cum calculul este limbajul pentru reprezentarea și tratarea ratelor de schimbare (a se vedea Zhoubin Ghahramani (2013) [28]. Organizarea tipică a datelor este în formă de matrice n-dimensionale, în care rândurile reprezintă eșantioanele (articolele de date), iar coloanele reprezintă atributele (trăsăturile), care pot fi văzute ca un vector n-dimensional de atribute și aria ca matrice Putem învăța din date – chiar și din datele de dimensiuni înalte din ℝ𝑛 – prin transformarea distribuțiilor de probabilitate anterioare în distribuții de probabilitate posterioare. Pentru a ilustra acest proces de învățare, să arătăm un exemplu simplu aici în ℝ2.
Notă: evenimentele sunt etichetate cu litere mari A; o variabilă aleatoare este, de asemenea, notată cu X majusculă și poate lua valori cu litere mici x; probabilitatea unui eveniment este capitală 𝑃(𝐴). O conexiune între valori și evenimente este în cazul „𝑋 = 𝑥”, adică evenimentul X ia valoarea x; O variabilă aleatorie discretă are o funcție de masă de probabilitate mică 𝑝(𝑥), iar legătura dintre P și p este aceea că 𝑃(𝑋 = 𝑥) = 𝑝(𝑥). Rețineți, de asemenea, că o variabilă aleatoare continuă are o funcție de densitate de probabilitate 𝑓(𝑥), iar legătura dintre P și f este aceea că 𝑃(𝑎 ≦ 𝑋 ≦ 𝑏) = ∫𝑏𝑎𝑓(𝑥)𝑑𝑥; în cele ce urmează folosim ℎ𝑛 pentru a indica o ipoteză n, și 𝜃 pentru a indica valoarea ipotetică a unui parametru de model; folosim majuscule 𝒟 când vorbim despre date ca evenimente și x când vorbim despre date ca valori. Expresia 𝑝(𝑥) cu 0 ≦ 𝑝(𝑥) ≦ 1 denotă probabilitatea ca x să fie adevărat. Folosind Bayes putem acum în loc de 𝑥,𝑦 să notăm d pentru date și h pentru ipoteză, iar cu majuscule ℋ = {ℎ1, ℎ2, …, ℎ𝑛} să definim spațiul ipotezelor; atunci ∀(ℎ,𝑑)
(1) 𝑃(ℎ|𝑑) = 𝑃(𝑑|ℎ)𝑃(ℎ)/∑ℎ′∈ℋ(𝑃(𝑑|ℎ′)𝑃(ℎ′))
Acum putem folosi notația ML prin înlocuirea simbolurilor: înlocuim d cu 𝒟 pentru a indica setul nostru de date observate și înlocuim h cu 𝑝(𝜃) pentru a desemna parametrii (încă) necunoscuți ai modelului nostru. se numește vectorul parametri (setul de parametri care a generat (𝑥,𝑦)), iar scopul este de a estima 𝜃 din x și y dați. Să luăm în considerare n date conținute într-o mulțime 𝒟 = 𝑥1:𝑛 = {𝑥1, 𝑥2, …, 𝑥𝑛}, și fie probabilitatea 𝑝(𝒟|𝜃) și să specificăm o anterioară 𝑝(𝜃), putem calcula astfel posterioara:
(2) 𝑝(𝜃|𝒟) = 𝑝(𝒟|𝜃)𝑝(𝜃)/𝑝(𝒟)
Figura 1 ilustrează acest proces de învățare: Primim funcția de probabilitate posterioară (verde) prin înmulțirea probabilității anterioare (roșu) cu funcția de asemănare (albastru), împărțită la dovezi (normalizare – în spații cu dimensiuni mari, aceasta este o provocare pentru calcul) . Pe scurt: posterioara este probabilitatea înmulțită cu precedenta prin dovezi, iar probabilitatea inversă ne permite să învățăm din date, să deducem necunoscute și să facem predicții [29].
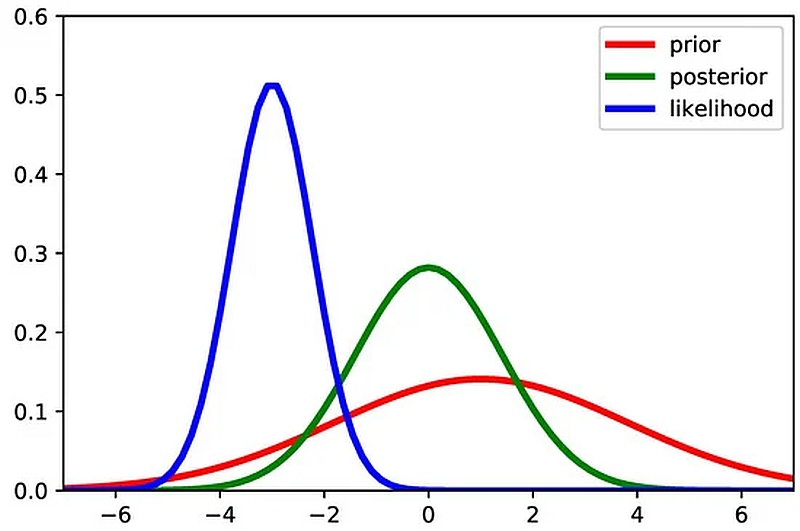
Figura 1. Funcția de probabilitate posterioară (verde) este obținută prin înmulțirea probabilității anterioare (roșu) cu asemănarea (albastru), împărțită la dovezi.
Referințe
- Simovici, D.A.; Djeraba, C. Mathematical Tools for Data Mining; Springer: London, UK, 2014. [Google Scholar]
- Jaynes, E.T. Probability Theory: The Logic of Science; Cambridge University Press: Cambridge, UK, 2003. [Google Scholar]
- Ghahramani, Z. Bayesian non-parametrics and the probabilistic approach to modelling. Trans. R. Soc. A Math. Phys. Eng. Sci. 2013, 371, 1–20. [Google Scholar] [CrossRef] [PubMed]
- Ghahramani, Z. Probabilistic machine learning and artificial intelligence. Nature 2015, 521, 452–459. [Google Scholar] [CrossRef] [PubMed]
Sursa: Holzinger, A. Introduction to MAchine Learning & Knowledge Extraction (MAKE). Mach. Learn. Knowl. Extr. 2019, 1, 1-20. https://doi.org/10.3390/make1010001. Licența CC BY 4.0. Traducere și adaptare © 2024 Nicolae Sfetcu

Inteligența, de la originile naturale la frontierele artificiale – Inteligența Umană vs. Inteligența Artificială
Inteligența: redefinirea frontierelor. Explorarea Inteligenței Umane și Artificiale. Descoperă, învață și imaginează-ți viitorul.
Tehnologia Blockchain – Bitcoin
Transformă-ți perspectiva asupra tehnologiei blockchain și începe să descoperi oportunitățile digitale de mâine!

Big Data: Modele de afaceri – Securitatea megadatelor
Nu rata oportunitatea de a rămâne competitiv într-o lume bazată pe date!
Descoperă mai multe la MultiMedia
Abonează-te ca să primești ultimele articole prin email.


Lasă un răspuns