




Securitatea QKD a fost dovedită riguros într-o serie de lucrări recente. A existat un interes extraordinar pentru QKD experimental [26] [27]. Din păcate, toate aceste experimente recente interesante sunt, în principiu, nesigure din cauza imperfecțiunilor din viața reală. Mai concret, laserele puternic atenuate sunt adesea folosite ca surse. Dar, aceste surse produc uneori semnale care conțin mai mult de un foton. Aceste semnale multi-fotonice deschid ușa către noi atacuri puternice de interceptare, inclusiv atacul de divizare a fotonilor. De exemplu, Eve poate, în principiu, să măsoare numărul de fotoni al fiecărui semnal emis de Alice și să suprime selectiv semnalele cu un singur foton. Ea împarte semnalele cu mai mulți fotoni, păstrând o copie pentru ea și trimițând o copie lui Bob. Acum, din moment ce Eve are o copie identică a ceea ce posedă Bob, securitatea necondiționată a QKD este complet compromisă.
În concluzie, în protocolul standard BB84, numai semnalele provenite din impulsuri de foton unic emise de Alice sunt garantate a fi sigure. În consecință, parafrazând GLLP (Gottesman, Lo, Lutkenhaus, Preskill [28]), rata de generare a cheilor securizate (per starea semnalului emisă de Alice) poate fi demonstrată ca fiind dată de:
S ≥ Qμ{−H2(Eμ) + Ω [1 − H2(e1)]}, (E10)
unde Qμ și Eμ sunt respectiv câștigul și rata de eroare cuantică pe biți (QBER) a stării semnalului (aici, câștigul înseamnă raportul dintre numărul de evenimente de detecție ale lui Bob (unde Bob alege aceeași bază ca Alice) și numărul de semnale emise de Alice. QBER înseamnă rata de eroare a evenimentelor de detecție ale lui Bob pentru cazul în care Alice și Bob utilizează aceeași bază), Ω și e1 sunt respectiv fracția și QBER-ul evenimentelor de detecție ale lui Bob care au provenit din semnale cu un singur foton emise de Alice, iar H2 este entropia binară Shannon. Este o a priori foarte dificil să se obțină o limită inferioară bună pentru Ω și o limită superioară bună pentru e1. Prin urmare, metodele anterioare (cum ar fi în GLLP [28], sub ipoteze (semi-)realiste, dacă imperfecțiunile sunt suficient de mici, atunci BB84 este necondiționat sigur) fac cea mai pesimistă presupunere că toate semnalele multi-fotonice emise de Alice vor fi recepționate de Bob. Din acest motiv, până acum, s-a crezut pe scară largă că cererea de securitate necondiționată va reduce drastic performanța sistemelor QKD.
În [29], aceștia prezintă o metodă simplă care va oferi limite foarte bune pentru Ω și e1. Metoda se bazează pe ideea stării capcană propusă pentru prima dată de Hwang [12]. Deși ideea lui Hwang a fost extrem de inovatoare, analiza sa de securitate a fost euristică. În consecință, metoda lui H.K. Lo etc. face pentru prima dată ca majoritatea experimentelor QKD la distanță lungă raportate în literatura de specialitate să fie necondiționat sigure. Iar metoda lor are avantajul că poate fi implementată practic cu hardware-ul actual. Așadar, spre deosebire de soluțiile anterioare bazate pe surse cu un singur foton, metoda lor nu necesită dezvoltări experimentale descurajante. Punctul cheie al ideii stării capcană este că Alice pregătește un set de stări suplimentare – stări capcană, pe lângă stările standard BB84. Aceste stări capcană sunt utilizate doar în scopul detectării atacurilor de interceptare, în timp ce stările standard BB84 sunt utilizate doar pentru generarea de chei. Singura diferență dintre starea capcană și stările standard BB84 constă în intensitățile lor (adică distribuțiile numărului de fotoni). Prin măsurarea randamentelor și a QBER-ului stărilor capcană, Alice și Bob pot obține limite fiabile pentru Ω și e1, permițându-le astfel să depășească substanțial toate rezultatele anterioare [30].
Mai întâi, reamintim în detaliu QKD a stării capcană original a lui Hwang [12].
Definim Yn = randament = probabilitatea condiționată ca un semnal să fie detectat de Bob, dat fiind că este emis de Alice ca o stare de n fotoni.
Pentru a proiecta o metodă de testare experimentală a randamentului (adică a transmitanței) multi-fotonilor, putem folosi stări cu doi fotoni drept capcană și testa randamentul acestora. De exemplu, Alice și Bob estimează randamentul Y2 = x/N dacă Alice trimite N semnale cu doi fotoni către Bob și Bob detectează x semnale. Dacă Eve trimite selectiv mai mulți fotoni, Y2 va fi anormal de mare. Deci Eve va fi prinsă.
Cele două tipuri de stări sunt următoarele pentru starea capcană QKD (Modelul Toy).
- Starea semnalului: Distribuția numărului de fotoni Poisson μ (la Alice).
- Starea capcană: semnale cu doi fotoni.
Procedura stării capcană QKD (Modelul Toy) este următoarea.
- Alice trimite aleatoriu fie o stare de semnal, fie o stare capcană către Bob.
- Bob confirmă primirea semnalelor.
- Alice anunță public care sunt stări de semnal și care sunt stări capcană.
- Alice și Bob calculează probabilitatea de transmisie pentru stările de semnal și, respectiv, pentru stările capcană.
Dacă Eve transmite selectiv doi fotoni, o fracțiune anormal de mare din starea capcană b) va fi recepționată de Bob. Eve va fi prinsă. Însă problema practică cu modelul Toy este că este dificil să se realizeze o stare perfectă cu doi fotoni. Așadar, soluția QKD a stării capcană a lui Hwang este de a crea un alt amestec de fotoni buni și răi cu o greutate diferită.
Există două tipuri de stări pentru starea capcană QKD a lui Hwang.
- Starea semnal: Distribuția numărului de fotoni Poisson: α (la Alice) cu amestecul 1.
- Starea capcană: Distribuția numărului de fotoni Poisson: μ∼2 (la Alice) cu amestecul 2.
Dacă Eve lasă o fracțiune anormal de mare de multi-fotoni să meargă la Bob, atunci stările capcană (care au o pondere mare de multi-fotoni) vor avea o transmisie anormal de mare. Prin urmare, Alice și Bob o pot prinde pe Eve.
Dar există unele dezavantaje ale ideii originale a lui Hwang:
- Analiza de securitate a lui Hwang a fost euristică, mai degrabă decât riguroasă.
- „Numărătoarea întunecată” – un efect important – nu este luată în considerare.
- Rezultatele finale (distanța și rata de generare a cheilor) sunt neclare.
Să presupunem că o stare capcană și o stare semnal au aceleași caracteristici (lungime de undă, informații de sincronizare etc.) prin metodele lui H.K. Lo etc. [29]. Prin urmare, Eve nu poate distinge o stare capcană de o stare semnal, iar singura informație disponibilă pentru Eve este numărul de fotoni dintr-un semnal. Prin urmare, randamentul, Yn (randamentul unui semnal de n-fotoni) și QBER, en (rata de eroare cuantică pe biți a unui semnal de n-fotoni), pot depinde doar de numărul de fotoni, n, dar nu și de distribuția (capcană sau semnal) din care provine starea. Dacă Eve nu poate trata starea capcană diferit de starea semnal, atunci
Yn(semnal) = Yn(capcană) = Yn
en(semnal) = en(capcană) = en.
Să ne imaginăm că Alice variază pe toate valorile nenegative ale lui μ aleatoriu și independent pentru fiecare semnal, Alice și Bob pot măsura experimental randamentul Qμ și QBER Eμ.
Qμ = Y0e−μ + Y1e−μμ + Y2e−μ(μ2/2) + … + Yne−μ(μn/n!) + …. (E11)
QμEμ = Y0e−μe0 + Y1e−μμe1 + Y2e−μ(μ2/2)e2 + … + Yne−μ(μn/n!)en + …. (E12)
Deoarece relațiile dintre variabilele Qμ și Yn și dintre Eμ și en sunt liniare, având în vedere mulțimea de variabile Qμ și Eμ măsurate din experimentele lor, Alice și Bob pot deduce matematic cu încredere ridicată variabilele Yn și en. Aceasta înseamnă că Alice și Bob pot constrânge simultan randamentele Yn și QBER en pentru toate valorile n. Presupunem că Alice și Bob își cunosc bine proprietatea canalului. Atunci, ei știu ce interval de valori pentru Yn și en este acceptabil. Orice atac al Evei care va schimba substanțial valoarea oricăruia dintre Yn și en va fi, în principiu, prins cu o probabilitate mare prin metoda stării capcană. Prin urmare, pentru a evita să fie detectată, Eve, care ascultă clandestin, are opțiuni foarte limitate în atacul său de interceptare. În concluzie, capacitatea lui Alice și Bob de a verifica experimental valorile lui Yn și en în metoda stării capcană le întărește considerabil puterea în detectarea interceptărilor, ducând astfel la o îmbunătățire dramatică a performanței sistemului lor QKD. Metoda stării capcană le permite lui Alice și Bob să detecteze abateri de la comportamentul normal datorate atacurilor de interceptare.
În [29], aceștia oferă, de asemenea, pentru prima dată o analiză riguroasă a securității stării capcană QKD. Mai mult, ei arată că ideea stării capcană poate fi combinată cu analiza GLLP anterioară. Și putem obține rezultatele comparației cu și fără starea capcană, așa cum se arată în Figura 3 următoare.
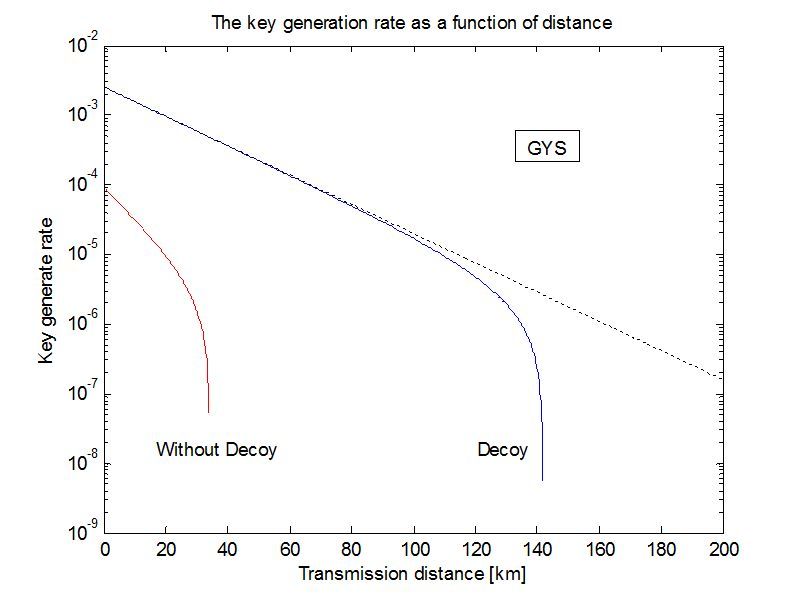
Figura 3. Compararea rezultatelor cu și fără starea capcană.
Referințe
12.RHorodeckiPHorodeckiMHorodeckiet al., “Quantum entanglement,” Reviews of Modern Physics, 8128659422009
26.AEkertComplex and unpredictable Cardano,” International Journal of Theoretical Physics, 47821012119Aug, 2008
27.WVan DamG. M. DArianoAEkertet al., “Optimal phase estimation in quantum networks,” Journal of Physics a-Mathematical and Theoretical, 402879717984Jul 13, 2007
28.MChristandlNDattaAEkertet al., “Perfect state transfer in quantum spin networks,” Physical Review Letters, 9218May 7, 2004
29.H. KLoX. FMaand KChenDecoy state quantum key distribution,” Physical Review Letters, 9423Jun 17, 2005
30.MCurtyOGühneMLewensteinet al., “Detecting two-party quantum correlations in quantum-key-distribution protocols,” Physical Review A, 7120223062005
Sursa: Xiaoqing Tan (2012). ”Introduction to Quantum Cryptography”, din Theory and Practice of Cryptography and Network Security Protocols and Technologies, Cap. 5, http://dx.doi.org/10.5772/56092, licența CC BY 3.0. Traducere și adaptare: Nicolae Sfetcu
Descoperă mai multe la MultiMedia
Abonează-te ca să primești ultimele articole prin email.

Lasă un răspuns