Clasificarea statistică în știința datelor

|

Când clasificarea este efectuată de un computer, se utilizează în mod normal metode statistice pentru a dezvolta algoritmul. Adesea, observațiile individuale sunt analizate într-un set de proprietăți cuantificabile, cunoscute sub numele de variabile explicative sau caracteristici. Aceste proprietăți pot fi … Citeşte mai mult

Date numerice în știința datelor: cuantile

|

O cuantilă este un număr real între 0 și 1 care reprezintă un „punct de delimitare” al unui set de date numerice: aproximativ, este numărul pentru care o anumită fracțiune a valorilor este mai mică decât acel număr. Deci, „cuantila … Citeşte mai mult

Cauzalitatea în știința datelor – Cazul negativ: „schelete” identice

|

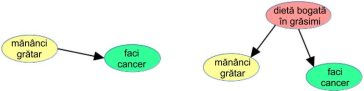
Acum trebuie să vă rog să vă uitați în memoria voastră până la Capitolul 10 al volumului anterior al acestei serii de cărți. Capitolul respectiv, intitulat „Interpretarea datelor”, trata asocierea versus cauzalitatea, factorii de confuzie, experimentele controlate versus studiile observaționale … Citeşte mai mult

Raționamentul probabilistic în știința datelor

|

Teoria probabilităților este un domeniu al matematicii care se ocupă cu cuantificarea incertitudinii. Este posibil să nu fim siguri că ceva se va întâmpla, dar vrem să fim preciși în ceea ce privește cât de siguri suntem, având în vedere … Citeşte mai mult

Series de copiere pentru matrice asociative în Python în știința datelor

|

Regulile pentru Series de copiere (sau necopiere) sunt exact aceleași ca pentru matricele NumPy. Dacă pur și simplu atribuiți un obiect Series unei alte variabile, cele două variabile vor indica aceeași Series din memorie, ceea ce înseamnă că modificările aduse … Citeşte mai mult

Factori de confuzie în interpretarea datelor în știința datelor

|

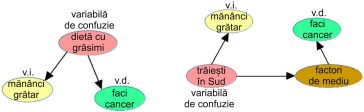
Permiteți-mi să vorbesc în special despre două dintre elementele din tabelul din Figura 10.1. Al treilea din listă, cauzalitatea externă, este un caz în care intră în joc o a treia variabilă (să o numim C). Ne referim la aceasta … Citeşte mai mult

Știința datelor – Extragerea datelor din paginile web (1 din 2) – Din HTML

|

Bine ați venit în cea mai rea dintre toate lumile posibile[1]: atunci când datele pe care doriți să le analizați se află undeva pe un site web ușor de citit de om, dar neprietenos cu mașinile. Sunt acolo, le puteți … Citeşte mai mult

Știința datelor: Evaluarea unui clasificator

|

Odată ce am construit un clasificator – fie că este vorba de un arbore decizional sau de orice alt tip – următorul pas este să îl evaluăm pentru a vedea cât de bine funcționează. Aceasta se numește uneori performanța clasificatorului. … Citeşte mai mult

Accesarea bazelor de date în știința datelor- Tipuri de baze de date

|

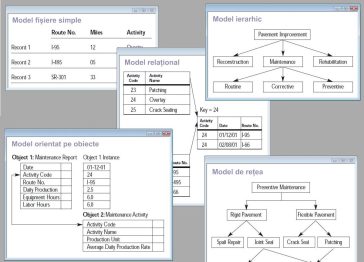
„Bază de date” este un termen foarte vag pentru „un depozit de informații care poate fi accesat cu ușurință”. Când folosim acest termen în știința datelor, ne referim la o sursă de date gestionată de un software numit SGBD sau … Citeşte mai mult

Utilizarea logaritmilor în știința datelor cu Python

|

Reamintim că logaritmul este operația inversă a exponențierii. Cât este 103? 1.000. Deci, care este logaritmul lui 1.000? 3. Este chiar atât de simplu. În loc să întreb: „Cât este zece la această putere?”, întreb „La ce putere aș ridica … Citeşte mai mult

Știința datelor: date și ore în Python (datetime)

|

Una dintre cele mai comune categorii de informații cu care te vei ocupa vreodată este cea care se ocupă de diferite aspecte ale timpului. Se pare că acest lucru este mult mai complex decât ați crede la început. În primul … Citeşte mai mult

Recodificare și transformare în știința datelor cu Python – Recodificarea cu operații simple

|

Este adesea cazul că, deși un DataFrame conține informațiile brute de care aveți nevoie, nu este exact în forma de care aveți nevoie pentru analiza dvs. Poate că datele sunt în unități diferite decât aveți nevoie – metri în loc … Citeşte mai mult

1 2 3 4